
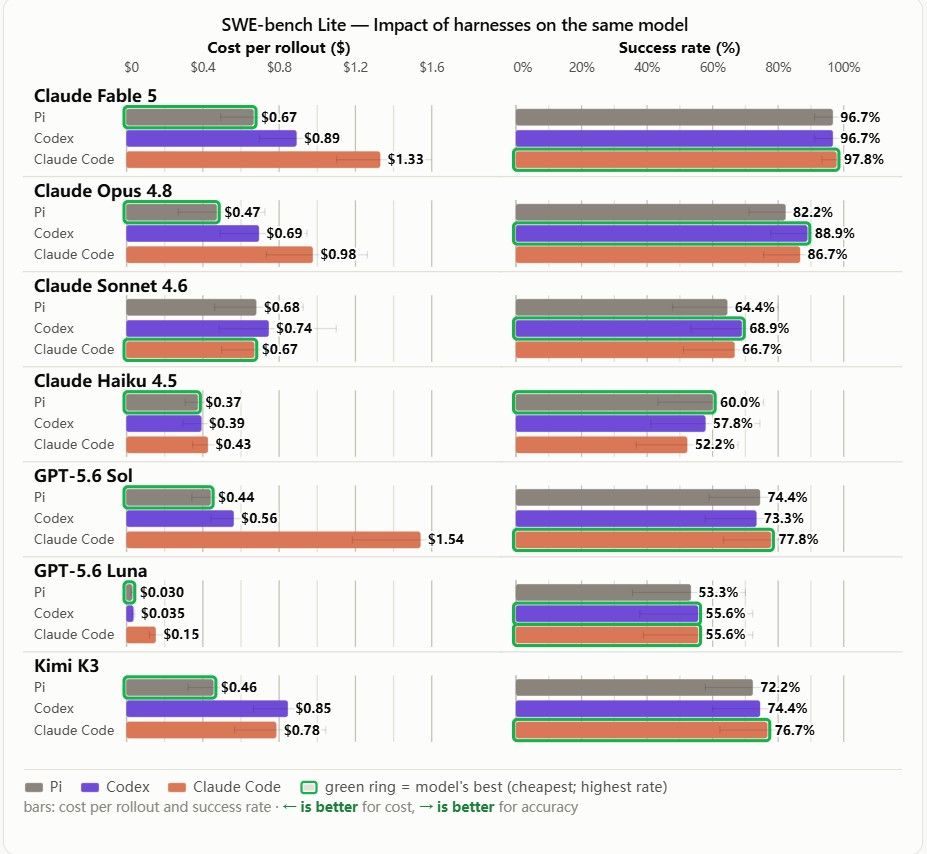
我发现有几个非常有趣的结论。
0 、harness 基本不影响模型表现。
1 、文章中的模型,在别家 harness 中表现比自家更好……
2 、Pi 的效率最高。
3 、综合完成度 CC 最高,但是代价是接近 Pi 两倍的 token 消耗量。
我发现有几个非常有趣的结论。
0 、harness 基本不影响模型表现。
1 、文章中的模型,在别家 harness 中表现比自家更好……
2 、Pi 的效率最高。
3 、综合完成度 CC 最高,但是代价是接近 Pi 两倍的 token 消耗量。
 |
1
Tink 1 day ago
我之前用几个任务测了 Pi 和 CC,发现 Pi 确实非常省 token,但是质量一言难尽,问了几轮都达不到点子上,没办法换成 CC 一轮过去,然后又切回 Pi 继续干。
后面就是优先用 Pi,解决不了的,切到 CC 干完再切回去 |
 |
2
longaiwp 1 day ago
其实从这个测评来看,国产模型用 CC 还是很有道理的
|
 |
4
yh7gdiaYW 1 day ago
这两个评测集选择的非常差,SWE-bench Lite / Terminal-Bench 2 这俩在训练时已经污染了,pi 在新一点的评测集和实际项目表现中没有这么好
|
|
5
yh7gdiaYW 1 day ago
Terminal-Bench 2 的结果稍微正常点,SWE-bench Lite 的结果真是离了大谱,O/A 家的模型在对方的 harness 里居然跑分更高...我要是跑出这么个结果,不"优化"下数据都不敢拿出来
|
 |
6
sentinelK OP |
 |
7
keakon 1 day ago
我也评测过,所以只用自己写的 agent
https://i.imgur.com/a/0c6Sov2.png |
|
8
keakon 1 day ago
图没发成功
 |
 |
9
greentim 18h 4m ago
我之前做过 不同 coding Agent 用 harness 和 原生表现的差距 https://mp.weixin.qq.com/s/k92i1_ORy5mDE1bOdRG-kw “理想照进现实:Kimi-K3 编程能力深度测评” 里面有 kimi3 、DeepSeek 。coding agent trae 、qoder ,对比非常明显
|
 Select Language